موکا: پیکاسو کوچولوی من
چند ماهیه که من کلا زیاد با مدل های هوش مصنوعی سر و کله میزنم. مدل های زیادی هم ساختن که بعدا توی پست های بعدی بیشتر درموردشون صحبت میکنم. و خب این بار رفتم و یه مدل مولد تصویر ساختم که انصافا تجربه باحالی شد.
معماری
اول یه سری بررسی ها کردم و دیدم یه سری مدل ها هستن به نام VAE یا Variant Auto Encoder این مدل ها روش کارشون این شکلیه که یه Encoder تصویر رو از یه سایز فشرده میکنه تا به Latent Size ما برسه، در مرحله بعد یه Decoder میاد و اون Latent رو به یه تصویر تبدیل میکنه.
من هم اولش میخواستم با همین معماری جلو برم. اما به این نتیجه رسیدم که خوب نیست. خودم تستش کردم. تصاویر تار بود. و خلاصه خوشم نیومد
با یه کم جستجو بیشتر رسیدم به معماری Diffusion که میشه گفت خیلی از مدل های تولید تصویر امروزی بر پایه همین معماری هستن (البته یه سری تعییرات ریز نسبت که نسخه کلاسیک دارن)
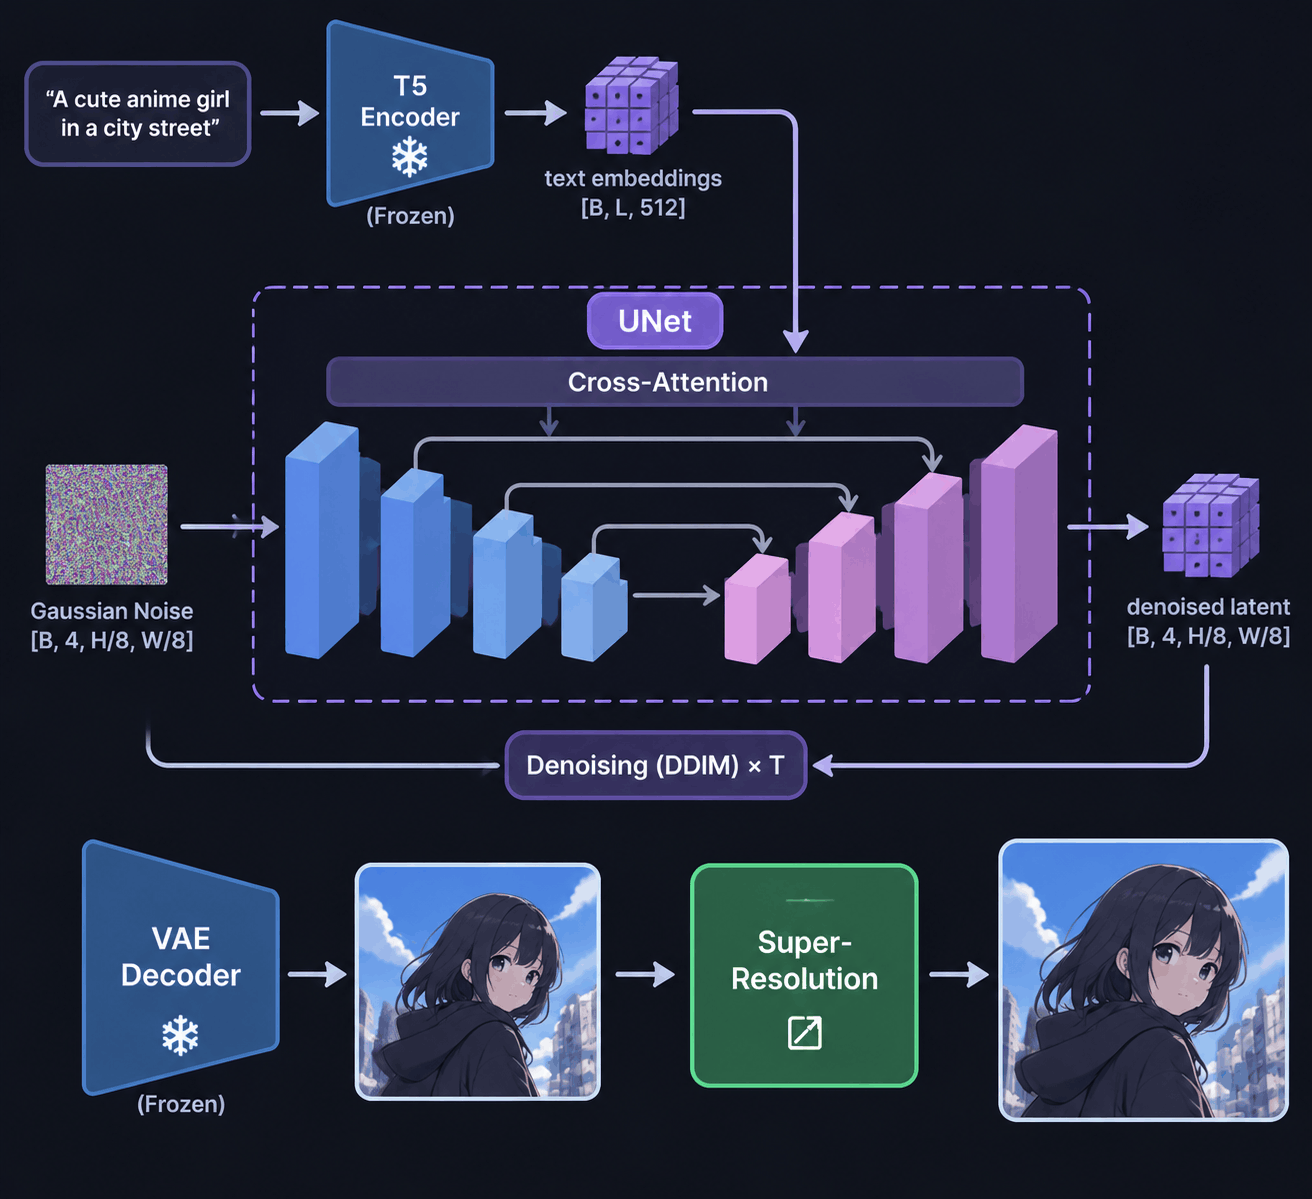
من از نسخه کلاسیکش که همون UNet معمولیه استفاده کردم. همراه با یه Cross Attention و یه مدل T5 Small برای انکود کردن پرامپت
مدل من اول با مدل با VAE نویز ورودی رو تبدیل به یه latent میکنه. در مرحله بعد با T5 پرامپت انکود میشه. حالا Diffusion توی نمایش عددی شروع میشه و بعد از این مرحله با VAE، latent بدست اومده رو به تصویر تبدیل میکنیم و تصویر بدست اومده رو به یه مدل Super Resolution میدیم و تصویر رو به ابعاد بزرگتر میبریم.
چطور آموزشش دادم؟
خب. از اونجایی که خودم یه کارت گرافیک به درد بخور دم دست نداشتم و colab تنها راهم بود مجبور بودم خودم رو به چند میلیون پارامتر (نسخه اولیه ۹ میلیون پارامتر داشت) محدود کنم. برای همین گفتم فقط یه سبک تصویر بهش آموزش میدم و چه چیزی بهتر از انیمه؟ بهش آموزش دادم و حیرت آور بود. خداوکیلی خودم خیلی هیجان زده شدم. چون یه سبک بود خوب میتونست تولید کنه
مدل های مولد خیلی چیزای خفنی هستن. مخصوصا وقتی خودت یکی رو از صفر آموزش بدی و خروجی کار رو ببینی…